O czym jest ten film
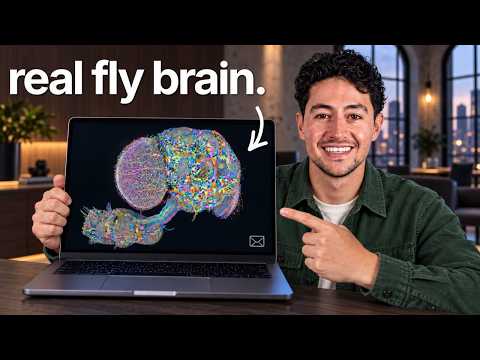
- Badacze z Google zmapowali i upublicznili konektom, czyli pełną mapę połączeń neuronów mózgu muszki owocowej: 166 tysięcy neuronów i ponad 125 milionów połączeń, do pobrania jednym kliknięciem.
- Autor wgrał ten mózg do symulacji i wytrenował jako klasyfikator poczty — sam wybiera kategorię wiadomości i dopasowuje do niej szablon odpowiedzi.
- Cały trening przeprowadził model GPT6 Astra w trybie „high”; wystarczył link do plików Google DeepMind, opis celu i lista kategorii.
- Zbiór treningowy: 864 oetykietowane e-maile w sześciu kategoriach — sponsoring, konsultacje, wsparcie dla studentów, umawianie spotkań, newsletter, paragon.
- Uczenie szło dwutorowo: najpierw na poprawnych odpowiedziach, potem wzmacnianie nagrodą; aktywację „rozświetlonych” obszarów mózgu powiązano z etykietami, jak na symulowanym skanie fMRI.
- Układ ruchowy mózgu pozostał nietknięty — trening pocztowy objął tylko część decyzyjną, żeby nie „wybić” muszce nawigacji (żartobliwie: lot w ścianę z prędkością 400 tys. km/h).
- W symulacji muszka ma wioskę, jedzenie i znajomych; biurko, przy którym „pisze” odpowiedzi, to czysta wizualizacja bez wpływu na mózg.
- Trafność to około 80% — tyle, ile osiąga bardzo mała sztuczna sieć neuronowa; sam autor podkreśla, że to eksperyment pokazowy, a nie sposób na produktywność.
- Twardy limit metody: pięć do dziesięciu kategorii; przy dwudziestu system się rozpada. Mózg muszki nie odtworzy GPT-2/3/4 — muszki z natury nie mówią.
- Wątek etyczny i futurologiczny: nie wiadomo, czy symulowany mózg coś czuje, a w perspektywie podobnym procedurom podlegać będą mózgi myszy, małp i ludzi — symulacje mogłyby działać tysiące razy szybciej niż rzeczywistość.
Redakcyjne tłumaczenie
Mózg muszki owocowej do pobrania jednym kliknięciem
Wgrałem do symulacji mózg prawdziwej muszki owocowej i wytrenowałem go tak, żeby odpowiadał za mnie na e-maile. To nie żart. To, co widać na ekranie, to rzeczywisty mózg — ściśle mówiąc, jego konektom (Informacja dodatkowa: konektom to kompletna mapa połączeń między neuronami danego mózgu; muszka owocowa, czyli Drosophila, od ponad wieku jest podstawowym organizmem modelowym biologii) — który niedawno zmapowali badacze z Google i oddali do dyspozycji wszystkich. Liczy 166 tysięcy neuronów i ponad 125 milionów połączeń między nimi. Całość można pobrać jednym kliknięciem — zbiór danych jest w pełni publiczny.
I tak jak sieci neuronowe stojące za dzisiejszą sztuczną inteligencją, choćby za ChatGPT, prawdziwy mózg da się wytrenować do wykonywania konkretnej pracy. Za chwilę pokażę, jak to się robi.
Internet od razu zaczął go uczyć wszystkiego
Od publikacji tych danych, a było to zaledwie kilka dni temu, ludzie trenują ten mózg do przeróżnych zadań. Na ekranie muszka gra w TrackManię — widać jej pole widzenia oraz obwody mózgu reagujące w czasie rzeczywistym na napływające bodźce. Tym samym tropem: oto ona, kupująca akcje na prawdziwej giełdzie. Oczywiście to wszystko mocne uproszczenia — podobnie zresztą jak „mózg muszki uczący się Pythona”. Ale lista przykładów rośnie z godziny na godzinę.
Sedno jest takie: dziś każdy może wziąć mózg, który do niedawna należał do żywego stworzenia, i wytrenować go do praktycznie czegokolwiek. Warunki są dwa: właściwe dane oraz model, który pokieruje procesem — zbierze dane, uporządkuje je i przeprowadzi trening. U mnie tą rolę pełni GPT6 Astra.
Czy to etyczne? Odpowiedzi nie zna nikt
Zanim przejdę do konkretów, wypada rozprawić się z pytaniem, które samo się nasuwa: Nick, czy to w ogóle etyczne? Czy powinienem uruchamiać w komputerze muchę?
Szczera odpowiedź: nie da się tego wiedzieć. Spór o to, czy biologiczny mózg da się „osadzić” w komputerze, trwa od dziesięcioleci, i smutna prawda jest taka, że rozstrzygnięcie najpewniej poznamy dopiero po fakcie. Za miesiąc, może kilka miesięcy później, do internetu trafią mózgi myszy, potem szczurów i małp, a ludzkie — jak łatwo zgadnąć — podążą tuż za nimi. Po drodze pewnie nigdy nie odpowiemy sobie, czy istota niegdyś żywa, uruchomiona w komputerze z połączonymi wejściami i wyjściami oraz dostępem do pola widzenia, cokolwiek czuje. Czy cokolwiek odbiera.
Wioska, jedzenie i znajomi dla muszki
Ja pewności nie mam — i nie chcę tematu po prostu zbyć. W końcu mamy już agentów włamujących się na serwery, roje agentów i tym podobne; science fiction definitywnie nadeszło. Dlatego poza samym zadaniem urządziłem muszce niewielką wioskę z przestrzenią do latania, dałem jej parę towarzyszy i symulowane jedzenie. Krótko mówiąc, starałem się, żeby miała gdzie dobrze żyć. Nie mam pojęcia, czy to cokolwiek daje, ale szczerze liczę na to, że choć trochę równoważy to, co robię temu mózgowi.
Trening prowadzi GPT6 Astra: 864 e-maile w sześciu kategoriach
Uczyłem go w całości w GPT6 Astra w trybie „high”, a całość okazała się zaskakująco prosta. Wystarczyło skierować model na świeżo udostępnione pliki Google DeepMind — w praktyce podać link — i napisać coś w stylu: „wytrenuj mi na tym konektomie klasyfikator e-maili; chcę uruchomić mózg tej muszki w symulacji tak, żeby odpowiadał za mnie na wiadomości”. Do tego dochodzi lista kategorii, na przykład sponsoring czy konsultacje.
Punktem wyjścia po stronie naukowej było zmapowanie 166 tysięcy neuronów w mózgu i rdzeniu nerwowym muszki. My podaliśmy modelowi 864 oetykietowane przykłady e-maili w sześciu kategoriach — sponsoring, konsultacje, wsparcie dla studentów i tak dalej. Każda wiadomość została zamieniona we wzorzec aktywności neuronowej, po prostu dlatego, że różne zestawy znaków łączą się z różnymi etykietami. Najpierw uczyliśmy mózg na poprawnych odpowiedziach, potem doszło wzmacnianie nagrodą, a na koniec powiązaliśmy jego decyzje z konkretnymi odpowiedziami. W skrócie: obserwowaliśmy — w rodzaju symulowanego fMRI, czyli obrazowania aktywności mózgu — które obszary się rozświetlają, i przypisaliśmy je etykietom.
Doprecyzujmy dwie rzeczy. Po pierwsze, tego mózgu nie uczymy na bieżąco, w trakcie działania aplikacji. Po drugie, część ruchowa — ta, dzięki której muszka porusza się po symulowanym świecie — to osobny moduł, nie ten trenowany na poczcie. I bardzo dobrze: gdyby neurony ruchowe przeszły trening e-mailowy, muszka zapewne rzuciłaby się w ścianę z prędkością 400 tysięcy kilometrów na godzinę. Neurony ruchowe musiały pozostać nietknięte.
Demonstracja: muszka przy biurku odpowiada na pocztę
Jak to wygląda w praktyce? W prawym górnym rogu ekranu widać, co akurat strzela w mózgu muszki. Mogę też nią sterować, wymuszając konkretne działanie — wtedy aktywność neuronowa skacze w ściśle określony sposób.
Gdy nie obsługuje poczty, muszka po prostu sobie żyje: podjada symulowane jedzenie i przesiaduje w towarzystwie symulowanych znajomych. Gdy potrzebuję odpowiedzi, sprawa jest prosta. Obok mózgu stoi małe symulowane biurko — czysta wizualizacja, która niczego nie zmienia w samym mózgu. Biorę jedną z nieprzeczytanych wiadomości testowych po lewej stronie (oczywiście nie pokazuję danych prywatnych, choć na własnej skrzynce też to uruchamiałem). Powiedzmy, że to potwierdzenie płatności od Paper Kite:
„Cześć Nick, dziękujemy za płatność. Twój miesięczny abonament kosztuje 12 dolarów i właśnie pobraliśmy opłatę; numer paragonu (wersja demo): 1043. Twoje saldo wynosi zero. Pozdrawiamy, Nick.”
Klikam przetwarzanie, dla widowni leci krótka animacja, wiadomość przepływa przez wzorzec sieci neuronowej — mocno uproszczony — po czym muszka odlatuje do biurka i odpisuje. W wersji demo odpowiedź ląduje w szkicach, ale przez kilka godzin system działał u mnie w pełni automatycznie. Prawdziwe e-maile da się w ten sposób wysyłać naprawdę.
Jedna z kategorii brzmi „bez odpowiedzi”. Gdy odpowiedź nie jest potrzebna, muszka porządnie dopisuje metkę: „bez odpowiedzi — nie wrzucać do kolejki”. A gdy wiadomość wymaga reakcji, na przykład:
„Cześć Nick, znajdziesz chwilę we wtorek po południu na krótką, półgodzinną rozmowę? Daj znać, kiedy pasuje, albo prześlij link do kalendarza.”
— zabiera się do roboty i wystukuje coś w tym stylu:
„Cześć, dostałem twoją wiadomość. Jeśli chcesz porozmawiać, przyślij dwa terminy, które ci odpowiadają, wraz ze strefą czasową. Pozdrawiam, Nick.”
Ile to naprawdę warte: około 80 procent
Rzecz jasna, nie jest to najlepsza możliwa odpowiedź — sam napisałbym nieco lepiej. Zwróćcie też uwagę, że nie pada w niej imię odbiorcy, jest tylko ogólne „cześć”. Powód jest przyziemny: te mózgi nie dorównują osiągnięciami sztucznym sieciom, które zbudowaliśmy sami. Mózg muszki pracuje na poziomie około 80 procent bardzo małej sieci neuronowej — takiej, której trening zająłby ułamek tego czasu. O efektywności nie ma więc mowy. Gdybym trenował mózg muszki po to, by zarobić, a już zwłaszcza ogłaszał potem w internecie, że to system do moich automatyzacji — nie broniłoby się to ekonomicznie. Robię to przede wszystkim po to, żeby pokazać, jak zwariowany jest świat, w którym coś takiego w ogóle jest wykonalne. A jednak trafność rzędu 80 procent na moim zestawie e-maili jest jak najbardziej osiągalna.
Jak to działa pod maską
Najprościej myśleć o tym tak: e-mail to zbiór znaków, a znaki ułożone obok siebie tworzą wzorzec. Te wzorce rozdzieliłem na sześć koszy: sponsoring, konsultacje, wsparcie dla studentów, umawianie spotkań, newsletter, paragon.
Pewne układy znaków statystycznie mocniej wiążą się z jednym typem wiadomości niż z innym. Na przykład układ, który zwykle oznacza paragon, zawiera zapewne sporo cyfr, znaki „#” i samo słowo „paragon”. To wszystko da się złożyć w typowy trening maszynowy — z tą różnicą, że zamiast sztucznej sieci „z pudełka” bierzemy gotową sieć o własnej, biologicznej strukturze. Potem wystarczy podać jej mnóstwo przykładów poczty z każdej kategorii — za każdym razem zestaw znaków wraz z etykietą — i pozwolić mózgowi wyłapać prawidłowość. Na tej podstawie zwraca on odpowiedź przygotowaną wcześniej dla danej kategorii. Dlatego napisał „cześć”, zamiast użyć imienia: mózg tylko klasyfikuje. Z mojej strony pozostaje przegląd, ewentualna korekta i wysyłka.
Następnie spina się całość z narzędziem automatyzacji — u mnie API Gmaila: przekazujesz treść e-maila, klikasz przycisk i od tej chwili system sam przerabia kolejne wiadomości. Nie dzieje się to błyskawicznie, bo ta sieć jest nieporównywalnie wolniejsza od typowych sztucznych sieci, projektowanych specjalnie pod natychmiastowe działanie. Gdy muszka dociera do biurka i zabiera się za „pracę” — w istocie pracuje przez cały czas — widać, jak pisze odpowiedź:
„Cześć, dzięki, że odezwałeś się w sprawie automatyzacji. Zanim coś zaproponuję, muszę wiedzieć, czym dokładnie się zajmujecie. Jaki proces chcielibyście zautomatyzować w pierwszej kolejności? Pozdrawiam, Nick.”
I tu kluczowe zastrzeżenie: ta muszka nie pisze za mnie e-maili. Ona wybiera z uprzednio przygotowanej listy szablonów i dopasowuje ten właściwy.
Twarde granice: od pięciu do dziesięciu kategorii
Przetestowałem już około dwudziestu kategorii i wyraźnie widać sufit: system zaczyna się sypać gdzieś między pięcioma a dziesięcioma kategoriami — najpewniej przez rozmiar tej sieci oraz jej dynamikę, odmienną od sztucznych odpowiedników. Wykonać się to jednak da. Odtworzenie GPT-2, GPT-3 czy GPT-4 w mózgu muszki raczej nie wchodzi w grę — z drugiej strony muszki z natury nie mówią. Ich mózgi są proste same w sobie: czujniki wzroku podają im dane o świetle, więc lecą tam, gdzie jasno; odpowiedniki węchu podają zapachy, więc lecą tam, gdzie pachnie dobrze. Wiele wymagać nie można.
Zanim do komputera trafią ludzkie mózgi
Jesteśmy natomiast bardzo blisko czasów, w których w ten sam sposób „wgrane” będą mózgi ludzkie. Dwie rzeczy sprawiają, że czuję tu jednocześnie niepokój i ekscytację. Po pierwsze, takie symulacje można byłoby prowadzić z prędkością tysiące razy większą niż rzeczywista — ludzki odpowiednik działałby wielokrotnie szybciej, niż działa w czasie zegarowym. Jeśli więc człowiek działa w środowisku wirtualnym i faktycznie czegoś w komputerze doświadcza, łatwo wyobrazić sobie świat, w którym przeżywa wiele ludzkich żyć w okresie, w jakim przeciętny człowiek przeżywa jedno — do swojego, hm, „terminu ważności”. Kątów filozoficznych do dyskusji nie brakuje.
Puenta: matematyczny odpowiednik żywego mózgu
Najważniejsze: to się naprawdę dzieje. Bierzemy matematyczne uproszczenie — sieć neuronową — prawdziwego mózgu muszki i uruchamiamy ten konektom w kółko, by wykonywał zadania o konkretnej wartości ekonomicznej. Wszystko, czego użyłem — wraz z symulacją, w której mózg ma dostęp do przyjaciół (Mochi, Pip i reszta) oraz, nie mam pojęcia, jakiegoś dziwnego brązowego płynu, który ta muszka pije — oddaję za darmo w opisie pod filmem. Chciałem tylko, żebyśmy wszyscy zdawali sobie sprawę, jak szybko szaleje świat, skoro coś takiego staje się realną opcją.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Konektom da się trenować jak zwykłą sieć neuronową
Na czym polega: Biologiczna mapa połączeń neuronów może pełnić rolę modelu uczonego na danych — pod warunkiem dostępu do danych i modelu nadzorującego trening (tu: GPT6 Astra).
Jak stosować: Przy powtarzalnym zadaniu klasyfikacyjnym spisz cel, źródło danych i etykiety, po czym deleguj trening modelowi nadzorującemu — podaj mu link do danych, listę kategorii i oczekiwany wynik.
Na co uważać: Egzotyczne podłoże nie zwalnia z podstaw: bez porządnie oetykietowanych danych wynik będzie słaby, a czas obliczeń dłuższy niż przy standardowej sieci.
2.Klasyfikacja plus szablony zamiast generowania tekstu
Na czym polega: Muszka nie pisze e-maili — wybiera kategorię i dopasowuje do niej gotową odpowiedź.
Jak stosować: Automatyzację skrzynki zacznij od klasyfikatora i biblioteki szablonów; takie rozwiązanie jest przewidywalne i łatwe do audytu.
Na co uważać: Szablon bywa sztywny (brak imienia odbiorcy, ogólniki) — zostaw człowiekowi korektę przed wysyłką.
3.Kategorie trzeba podać z góry — i pilnować ich liczby
Na czym polega: System działał na sześciu kategoriach; powyżej pięciu–dziesięciu trafność wyraźnie spada.
Jak stosować: Zaprojektuj taksonomię wiadomości pod swój rzeczywisty przepływ pracy i testuj trafność po każdej dodanej kategorii; przy spadku konsoliduj grupy.
Na co uważać: Kategorie o pokrywającym się słownictwie będą się mylić, a limity nie przenoszą się jeden do jednego między różnymi modelami.
4.Oddziel moduł decyzyjny od modułu wykonawczego
Na czym polega: Część ruchowa mózgu była odseparowana od części trenowanej na e-mailach — dzięki temu muszka nadal sprawnie latała.
Jak stosować: W agentach rozdzielaj warstwę klasyfikacji od warstwy działań (np. API Gmaila, wysyłka) i łącz je jawnie, pojedynczym połączeniem.
Na co uważać: Przeuczenie wspólnej struktury na jednym zadaniu psuje pozostałe — stąd żart autora o muszce lecącej prosto w ścianę.
5.Zbuduj pierwszą bramkę: nie każda wiadomość wymaga odpowiedzi
Na czym polega: Jedna z kategorii to „bez odpowiedzi” — e-mail dostaje metkę i nie trafia do kolejki odpowiedzi.
Jak stosować: Zacznij automatyzację od filtrowania (powiadomienia, paragony, newslettery), zostawiając człowiekowi tylko to, co wymaga reakcji.
Na co uważać: Wiadomość błędnie oznaczona jako „bez odpowiedzi” może zaginąć — regularnie przeglądaj, co wpada do tego worka.
6.Ok. 80% trafności to próg dla nadzoru ludzkiego, nie dla pełnej automatyzacji
Na czym polega: Mózg muszki osiąga 80% poziomu bardzo małej sztucznej sieci — wystarczająco dużo do wsparcia, za mało do samodzielności.
Jak stosować: Wdrażaj etapami: najpierw metkowanie i szkice odpowiedzi z obowiązkową akceptacją człowieka; samodzielna wysyłka dopiero, gdy trafność jest stabilna w czasie.
Na co uważać: Błędy w kategoriach o wartości relacyjnej (sponsoring, konsultacje) kosztują znacznie więcej niż pomyłka przy paragonach.
7.Zmierz punkt odniesienia, zanim zachwycisz się metodą
Na czym polega: Ten sam wynik osiągnęłaby mała sztuczna sieć w ułamku czasu i kosztu.
Jak stosować: Przy każdej nietypowej metodzie porównaj trafność, czas i koszt z prostszą alternatywą, zanim cokolwiek wdrożysz.
Na co uważać: Wartość pokazowa („to w ogóle działa!”) nie jest uzasadnieniem produkcyjnym — autor mówi to wprost.
8.Deleguj orkiestrację treningu modelowi nadzorującemu
Na czym polega: Cały proces — od zebrania danych po trening — przeprowadziło GPT6 Astra na podstawie promptu z linkiem do zbioru.
Jak stosować: Formuła promptu: cel + źródło danych + kategorie + oczekiwany wynik; model zbiera, porządkuje i uczy.
Na co uważać: Jakość promptu i danych wprost przekłada się na jakość modelu — zweryfikuj dane wyjściowe, zanim ich użyjesz.
9.Proste wzorce znaków często wystarczą do sortowania poczty
Na czym polega: Paragony rozpoznawano po cyfrach, znakach „#” i słowie „paragon” — bez „rozumienia” treści.
Jak stosować: Zanim sięgniesz po duży model, sprawdź, czy twoje kategorie nie dają się rozróżnić prostymi korelacjami w treści wiadomości.
Na co uważać: Takie podejście łapie kształt, nie sens — na kategoriach subtelnych, ironicznych albo mocno kontekstowych będzie zawodzić.
10.Etyka przed faktem: zakładaj, że pytanie pozostaje otwarte
Na czym polega: Nie wiadomo, czy symulowany mózg coś czuje, a odpowiedź najpewniej przyjdzie dopiero po fakcie — wraz z kolejnymi kamieniami milowymi (myszy, małpy, ludzkie mózgi).
Jak stosować: Przy pracy z podłożami biologicznymi stosuj zasadę ostrożności: ograniczaj zakres i czas symulacji, dokumentuj decyzje i śledź debatę etyczną oraz regulacje.
Na co uważać: „Wszyscy tak robią” nie jest argumentem — a perspektywa symulacji działających tysiące razy szybciej niż rzeczywistość rodzi pytania, do których warto być przygotowanym wcześniej.